
答え合わせ:計算と実測を並べる
第 4 章では、コンピュータがエタノールの寄与を足して、log P(水と油のどちらになじむかを表す数)を 0.00 と見積もりました。 ところが、水とオクタノールに分けて実際に測った値(実測)は −0.30 です。第 5 章でも、炭素1個ぶんの log P が、第 4 章の寄与では +0.39、実測から学んだ規則では +0.56 と食いちがっていました。 計算と実測が食いちがうとき、どちらを信じればよいのでしょうか。この章では、これまでの章でコンピュータが出した答えを、実験の値と突き合わせます。
まず、実測の −0.30 を見直します。1989年にサングスターは、いくつもの研究室が測った log P を集めて表にしました。 エタノールには9つの報告が並んでいます。報告ごとに測った温度や濃度の測り方がちがうので、値は −0.32 から −0.15 まで散らばっています。 −0.30 は、サングスターが推奨した値です。
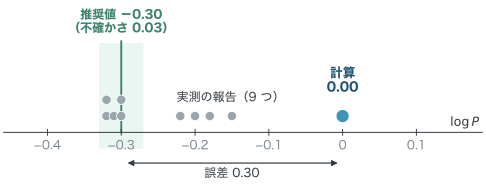
実測にも、このくらいの幅はあります。それでも、計算の 0.00 は、9つのどの報告よりも油の側にあります。 log P が 0.3 ちがうと、油と水の濃度の比は2倍ちがいます。計算では、エタノールは油の層と水の層に半分ずつ分かれますが、実測では、油の層にいるのはおよそ3分の1です。
では、ほかの分子ではどうでしょうか。水、お酒のエタノール、お酢の酢酸、防虫剤のナフタレン、コーヒーのカフェインなど、身近な分子を25個選び、 第 4 章と同じクリッペン法(原子ごとの寄与を足し合わせるやり方)で log P を計算しました。25個を合わせても、計算は0.01秒かかりません。 計算から実測を引いた差が、その分子の誤差です。
横の軸に実測、縦の軸に計算をとって並べると、計算と実測がぴったり合う分子は、斜めの線の上に乗ります。 25個のうち、誤差の大きさが0.5より小さい分子はいくつあるでしょうか。答えは14個で、半分ほどです。
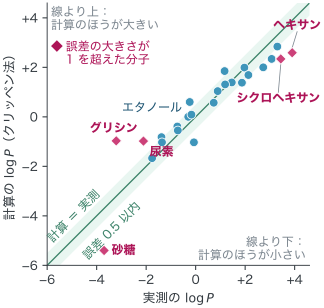
丸は全体として斜めの線にそって並んでいて、水になじむ分子か、油になじむ分子かは、計算でほぼ見分けられています。 一方で、誤差の大きさが1を超えた分子も5個ありました。25個の誤差の大きさ(マイナスの符号を外した値)を平均すると、0.62 です。 油と水の濃度の比でいえば、およそ4倍のちがいです。これが「原子寄与法はどこまで当たるか」という問いへの答えの1つです。
 テラ
誤差の理由:モデルが省いたもの
外れ方には、くせがあります。計算が水の側に外れた分子には、ヘキサンやシクロヘキサンのように、炭素と水素だけでできた分子が目立ちます。 反対に、計算が油の側に大きく外れたのは、グリシンと尿素です。外れ方にくせがあるのは、モデルが何かを省いているからです。
炭素1個ぶんの寄与:+0.39 と +0.56
C–H の多い分子で外れる理由を、第 5 章の直鎖のアルコールで確かめます。第 5 章では、実測から、炭素が1個増えるごとに log P が +0.56 増えるという規則を学びました。 第 4 章の寄与の足し算では、C と C にはさまれた CH2 1つで +0.39 です。 炭素が増えるほど寄与の足し算は実測より小さくなり、1-デカノール(炭素10個)では誤差が −1.45 になりました。第 5 章の規則なら −0.31 です。
クリッペン法の寄与は、およそ1万個の分子の実測に、まとめて合うように決めた値です。いろいろな分子に少しずつ合わせたので、直鎖のアルコールや、炭素と水素だけの分子にぴったり合うとは限りません。 一方、第 5 章の規則は直鎖のアルコールにはよく合いますが、ほかの種類の分子には使えません。どちらかが正しいのではなく、2つのモデルは省いたものがちがうのです。
また、寄与の足し算は、原子をとなりの原子とのつながりだけで見分けます。O–H が8つも近くに並ぶ砂糖では、それらが影響し合う分が数に入らず、計算が1.70も水の側に外れました。
ドッキングの答え合わせ
第 3 章のドッキングも、答え合わせをしておきます。2019年の大きなバーチャルスクリーニングでは、ある酵素に9,900万個の分子をドッキングし、 点数の上位から選んだ44個を作って試しました。阻害剤だったのは5個(11 %)です。
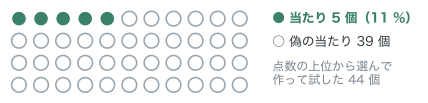
上位の分子でも、当たりは1〜2割ほどです。点数で、分子1つ1つの結合の強さや順位まで当てるのはむずかしいのです。 それでも、外れは多くても、点数は当たりの多い範囲を選び出すふるいとしてはたらき、9,900万個の中から作って試す44個を選んで、5個の阻害剤を見つけられました。
各章のモデルが省いたもの
第 1〜5 章で見たコンピュータの中の実験を、3つの問いでまとめ直すと、次のようになります。
第 1 章 見る・分子動力学
- 何をモデルにしたか
- 原子をつぶ、結合をばねにする(電子は省く)
- 何をくり返したか
- 力 → 加速度 → 速さ → 位置を1コマずつ。何百万コマも
- どこまで信じられるか
- 力の決め方しだい。結合が切れる反応は扱えない
第 2 章 見る・量子化学
- 何をモデルにしたか
- 原子核を止めて、電子だけを考える。電子どうしのかかわりは近似する
- 何をくり返したか
- 電子の雲を計算し、エネルギーの段差から光の色を求める
- どこまで信じられるか
- 近似の選び方で、色の予測に誤差が出る。大きな分子は計算が重い
第 3 章 探す・ドッキング
- 何をモデルにしたか
- 活性部位はほぼ動かない形に。水は省く。結合の強さは点数の式で見積もる
- 何をくり返したか
- 置く・回す・点数にするを、1分子で100万通り以上
- どこまで信じられるか
- 上位でも当たりは1〜2割。偽の当たりが混じる
第 4 章 予測する・ケモインフォマティクス
- 何をモデルにしたか
- 原子を、となりの原子だけで見分けて、寄与を足す
- 何をくり返したか
- 寄与の足し算を、1分子0.0002秒ほどで
- どこまで信じられるか
- 誤差の大きさの平均 0.62。炭素と水素ばかりの分子や、双性イオンは苦手(第 6 章で答え合わせ)
第 5 章 学ぶ・機械学習
- 何をモデルにしたか
- 規則を直線に、分子を数(炭素の数)にする
- 何をくり返したか
- 直線を少し動かして誤差を測るのを、何千回もくり返す
- どこまで信じられるか
- 学んだデータの範囲の外では、外れることがある
どのモデルも、何かを省いています。物理の法則から計算する方法も、省いたもののぶんだけ外れます。第 2 章のナトリウムでは、電子どうしのかかわりの近似を変えると、計算した光の波長は 557 nm から 628 nm まで分かれました(実測は 589 nm)。 第 4 章の腕比べでは、分子動力学などのつぶとばねの方法で求めた log P の誤差が、データから決める方法の2倍ほどありました。
省くことは、手抜きではありません。省くことで計算が速くなり、何億個もの分子を調べたり、何百万コマも分子を動かしたりできるようになります。 大切なのは、何を省いたかを知っておくことです。そうすれば、計算が外れたときに、どこを疑えばよいかが分かります。
計算にかかる時間
それなら、何も省かずに、ていねいに計算すればよいのではないでしょうか。そこで問題になるのが、計算にかかる時間です。 メタン、エタン、プロパン、……と、炭素を1つずつ増やした炭素と水素だけの鎖の分子を用意し、分子1個の計算にかかる時間を、ノートパソコンで測りました。 原子寄与法と、量子化学の計算を精度のちがう2つの近似(ふつうの精度・高い精度)で行ったものです。
分子の大きさが2倍になると、量子化学の計算時間は何倍になるでしょうか。
🖐 さわってみよう本の図 6-9・6-11
計算時間の爆発
分子の大きさを選んで「計算スタート」を押すと、3 つのやり方の競走が始まります。時間は、ノートパソコンの 1 コアで実際に測った値です。
原子寄与法
量子化学(ふつうの精度)
量子化学(高い精度)
予想してみよう:分子の大きさが2倍になると、量子化学の計算時間は何倍になると思いますか?
小さな分子では、精度の高いほうが速いこともあります。
答えは、ふつうの精度で8倍ほど、高い精度で37倍ほどです。 原子寄与法では、分子が大きくなっても、足す寄与の数が増えるだけです。量子化学の時間が急に増えるのは、電子どうしのかかわりを計算するからです。 電子の数が2倍になると、電子2個の組み合わせの数はおよそ4倍になり、ほかの手間も増えます。 炭素6個のヘキサンでは、ふつうの精度で5秒ほど、高い精度で47秒ほど。原子寄与法なら0.0001秒もかかりません。
 テオ
スーパーコンピュータでも
もっと速いコンピュータを使えば、どんな分子でも計算できるのでしょうか。日本のスーパーコンピュータ「富岳」には、計算をする部品(コア)が約763万個あります。 コア1つが1秒間にできる計算の回数は、ノートパソコンと同じくらいです。富岳の速さは、コアの数から来ているのです。
仮に、富岳のすべてのコアを1つの計算にむだなく使えたとします(実際には、コアどうしが結果をやりとりする時間などがあるので、いちばんうまくいったときの見積もりです)。 それでも、計算は763万倍速くなるだけです。そのとき計算できる分子の大きさを、上の図の増え方から見積もりました。上の図の「スーパーコンピュータ「富岳」なら?」を押してみてください。
原子寄与法なら、計算できる分子の大きさも、ほぼ同じだけ大きくなります。ところが量子化学では、ふつうの精度で200倍ほど、高い精度では10〜20倍ほどの大きさの分子までです。 分子が大きくなると計算時間が急に増えるので、コンピュータが速くなっても、計算できる分子はわずかしか大きくなりません。 スーパーコンピュータでも、何でもていねいに計算できるわけではないのです。
目的に合わせてモデルを選ぶ
そこで研究の現場では、目的に合わせてモデルを選びます。何億個もの分子をふるいにかけるときは、原子寄与法やドッキングのような速いモデルを使います。 誤差はありますが、何億個をまとめて調べられることのほうが大事だからです。ふるいに残った分子は、分子動力学や量子化学のような、省いたものの少ない遅いモデルで調べ直すこともあります。 そして最後に残った候補を、実際に作って実験で確かめます。第 4 章で原子寄与法と分子動力学を使い分けたのも、同じ考え方です。
計算と実験は両輪
実験で測った値は、計算のモデルを直すデータにもなります。 第 4 章の寄与も、第 5 章の規則も、実験で測った値から決めたものでした。測った値が増えれば、学習し直して、寄与や規則を新しくできます。 直したモデルで、また候補を絞ります。こうして、計算と実験は輪になって回ります。
天気予報も、同じようにして当たるようになってきました。序章で見たように、数値予報は、出した予報をあとで観測と比べる答え合わせをくり返し、モデルを直してきました。 気象庁は、予報した台風の中心と実際の中心との距離を1年分平均して、進路予報の誤差を毎年公表しています。
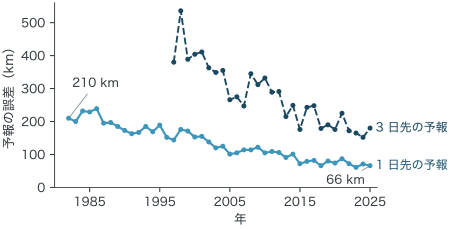
いまでは、3日先を予報したときの誤差が、1980年代に1日先を予報したときの誤差より小さくなっています。 その年に予報しやすい台風が多いかどうかで、誤差は年ごとに上下します。それでも長い目で見ると、精度は上がってきました。気象庁は、その理由として、数値予報のモデルの改良や、その使い方の改善などを挙げています。
答え合わせをくり返し、外れた理由を探してモデルを直す。天気予報も計算化学も、こうして進歩してきました。
AI を使いこなすのは化学が分かる人
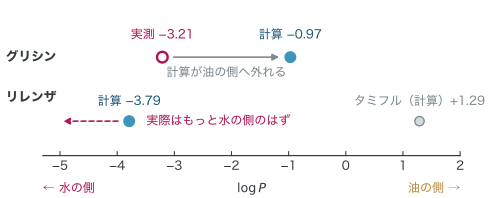
最後に、答え合わせでいちばん外れたグリシンを見ます。計算は −0.97、実測は −3.21 で、誤差は +2.24 です。 グリシンは、いちばん小さなアミノ酸です。水の中では、カルボキシ基の COOH が H+ を放して COO− になり、アミノ基の NH2 が H+ を受けとって NH3+ になります。 このように、1つの分子の中にプラスとマイナスの両方の電荷をもつイオンを、双性イオンと呼びます。
ところが、コンピュータに渡した結合表は、イオンになる前の形でした。グリシンは、水の中ではほぼいつも双性イオンで、イオンになる前の形をほとんどとりません。 双性イオンの COO− や NH3+ は、水分子にしっかり囲まれて水和するので、グリシンは油の層にはほとんど移らず、実測の log P はとても小さくなります。 計算にはこの形のちがいが入っていないので、油の側に大きく外れたと考えられます。
この外れに気づき、理由を説明できたのは、「アミノ酸は水の中で双性イオンになる」という化学の知識があったからです。 コンピュータは、渡された形が水の中の形とちがっていても、結合表のとおりに寄与を足して数を返します。答えがおかしいと気づくのは、使う人の仕事です。
この知識があると、第 4 章のリレンザの数にも目が向きます。リレンザも水の中では双性イオンで、−3.79 はグリシンと同じ向きにずれた見積もりだと考えられます。 それでも、「水になじみすぎて、飲み薬に向かない」という結論は変わりません。
機械学習や人工知能(AI)でも同じです。学んだデータの範囲の外でも、AI はもっともらしい数を返します。その数を信じてよいかどうかを判断するには、化学の知識が必要です。 計算や AI がどれだけ速くなっても、何を計算させるかを決め、答えを確かめる仕事は、化学が分かる人に残ります。
学んだ規則が、学んだデータの範囲の外でどう外れるかは、第 5 章の動く図の最後の「おまけ:覚えすぎると…」で試せます。 5つの点を全部通る複雑な規則も、もっともらしい数を返します。
テラテオテラ山本研究室でも、量子化学・分子動力学・機械学習を目的に合わせて組み合わせ、共同利用のスーパーコンピュータも使って計算しています。 企業や大学の研究者と組んで、作る前に計算で当たりをつけ、実験の結果と突き合わせています(研究内容・共同研究・技術相談)。次の終章では、小さな穴に二酸化炭素をとどめる材料を、作る前にコンピュータで絞りこむ研究を見ます。