
第 4 章では、コンピュータが原子のまとまりごとの寄与を足して、エタノールの log P をおよそ 0.00 と見積もりました。 では、こうした寄与の値は、だれが、どうやって決めたのでしょうか。寄与は原子タイプの数だけ、68 個あります。
実は、68 個の寄与は、log P を実験で測った 9,920 個の分子のデータに合うように、計算で決められました。 コンピュータは、どうやってデータから規則を見つけるのでしょうか。
 テオ
 テラ
測ったデータを並べる
log P を1回測るには、分子そのものを用意し、水とオクタノールを振って平衡にし、それぞれの層の濃度を分析する手間がかかります。 それでも、世界中の研究室が長い年月をかけて、いろいろな分子の log P を測ってきました。 1989年に、サングスターは、簡単な有機化合物 611 個について、それまでに報告された log P を集めて表にしました。
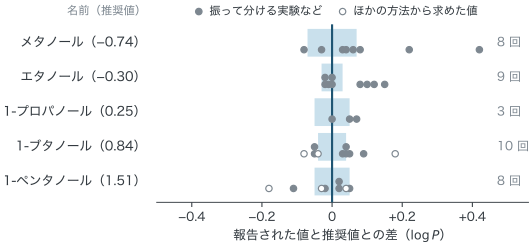
同じ分子でも、測る人や方法によって、値は少しずつちがいます。 サングスターは、報告された値を比べて、分子ごとにいちばん確からしい値を決め、推奨値としました。 推奨値には、本当の値がこのくらいの幅に入るだろう、という不確かさが付いています。この章では、この推奨値を実測の値として使います。
5つの分子は、どれも炭素が1列につながった鎖の端に、OH が1つついたアルコールです。ちがうのは、鎖の炭素の数だけです。 では、炭素が1個増えるごとに、log P はどう変わるでしょうか。散布図に並べてみます。
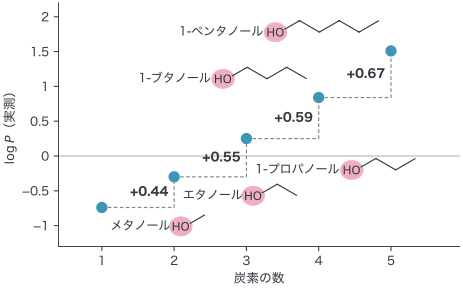
炭素が1個増えるごとに、log P はおよそ 0.5 ずつ上がります。CH₂ が1つ増えるたびに、分子は油になじみやすくなるのです。 丸は右上がりのほぼ一直線に並んでいて、炭素の数と log P には強い正の相関があります。
ただし、増加分は +0.44 から +0.67 までばらついていて、丸はぴったり一直線には並びません。 5つの丸にいちばんよく合う直線は、どれでしょうか。 そこで「いちばんよく合う」を数で決めて、コンピュータに線を探させます。
このように、測ったデータの表から、規則を表す数(パラメータ)を、コンピュータに計算で見つけさせることを、機械学習と呼びます。 見つけた規則を使えば、まだ測っていない分子の値も予測できます。
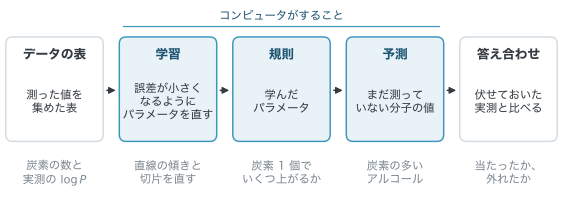
学習:予測と実測の誤差を小さくしていく
まず、コンピュータに渡すものを決めます。1つはデータの表です。分子の名前はそのままでは計算に使えないので、分子を「炭素の数」という数で表します。 もう1つは規則の形で、ここでは直線にします。
log P = a × 炭素の数 + b
a は直線の傾き、b は切片です。コンピュータの仕事は、5つの丸にいちばんよく合う a と b を探して、返すことです。 分子を炭素の数だけで表したので、鎖の枝分かれや OH の位置、ほかの原子のまとまりは省いています。この規則が使えるのは、OH を1つもつ直鎖のアルコールだけです。
手で1回、直線を動かす
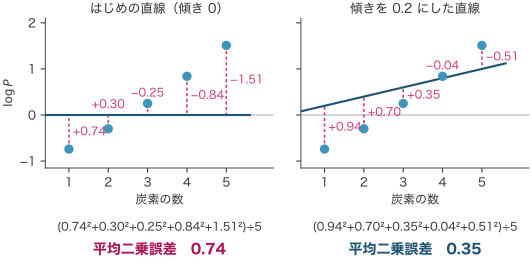
直線がどれだけ丸に合っているかを、数で表します。直線で予測した値から実測の値を引くと、予測の誤差が出ます。 誤差はプラスにもマイナスにもなるので、分散を求めるときと同じように、2乗してから平均します。 この数を平均二乗誤差といいます。直線が丸に合うほど、平均二乗誤差は小さくなります。
傾きも切片も 0 の直線、つまり、どの分子も log P = 0 と予測する直線から始めると、平均二乗誤差は 0.74 です。 切片はそのままで、傾きを 0.2 にすると、0.35 に下がりました。誤差が小さくなったので、この向きに動かしたのはよかったことになります。
コンピュータは何千回もくり返す
手でやると、どちらの向きにどれだけ動かすかを、毎回考えなければなりません。コンピュータは、決まった手順でくり返します。 いまの a と b を少し変えたら平均二乗誤差が増えるか減るかを計算し、誤差が下がる向きへ、a と b を少しだけ動かします。 これを 3,000 回くり返すと、平均二乗誤差は、はじめの 0.74 から 0.004 まで下がりました。かかる時間は 0.002 秒ほどです。
予測と実測の誤差を計算しては、誤差が小さくなるようにパラメータを直すことをくり返して、データに合う規則を見つけていく。これを学習と呼びます。 日常の「学習」とちがって、コンピュータは、なぜ炭素が増えると log P が上がるのかを理解しているわけではありません。誤差が小さくなる数を、計算で探しているだけです。
テラ誤差の地図を下る
横に a、縦に b をとって、平均二乗誤差の等しいところを線で結ぶと、地図の等高線のような図になります。 コンピュータは、いまいる場所で坂がいちばん急に下る向きを計算し、その向きへ少しずつ進みます。 坂の勾配(急さ)をたよりに下っていくので、この方法を勾配降下法と呼びます。たどり着いた谷の底は、a = +0.564、b = −1.38 でした。
🖐 さわってみよう本の図 5-6・5-8
誤差の地図を下る
ボタンを押すと、右の地図の上を点が坂の下へ進み、左の直線が丸に寄っていきます。地図のほかの場所を押すと、そこから下り直します。
回数 a b 誤差
どこから始めても、同じ谷の底に着きます。
規則が直線のときは、谷の底を1回の計算で求める式もあります。坂を下る方法は、規則の形がもっと複雑で、そうした式がないときにも使えます。
クリッペン法の式は、炭素の数にかける a が 68 個に増えた形をしています。 68 個の寄与は、9,920 個の分子で、予測と実測の誤差が小さくなるように決められました。直すパラメータも合わせる分子もずっと多くなりますが、考え方は同じです。
伏せておいた分子で答え合わせ
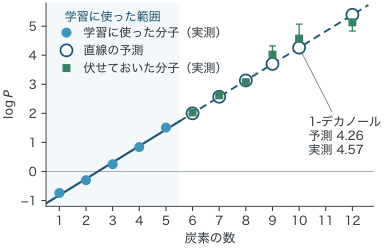
学習で見つかった規則は、log P = 0.564 × 炭素の数 − 1.38 です。炭素が1個増えるごとに、log P はおよそ 0.56 ずつ上がる、という規則です。 サングスターの表には、炭素が 6〜10 個と 12 個の直鎖のアルコールも載っています。答え合わせのために、これらの実測は伏せておき、学習には使いませんでした。
炭素が 10 個の 1-デカノールを、この規則で予測するといくつになるでしょうか。0.564 × 10 − 1.38 で、およそ 4.26 です。伏せておいた実測は 4.57 でした。 差の 0.31 は、実測の不確かさ 0.5 の範囲に収まります。ほかの分子でも、予測と実測の差は、実測の不確かさと同じくらいか、それより小さくなりました。
 テオ
規則の形も、予測の当たり外れを左右します。直線の代わりに、5つの丸をすべてぴったり通る4次式の曲線を引くと、学習に使った5つの分子では平均二乗誤差が 0 になります。 ところが、この曲線で 1-デカノールを予測すると、15.16(実測 4.57)と大きく外れます。測った値の小さなばらつきまで写しとるように、曲がってしまったのです。
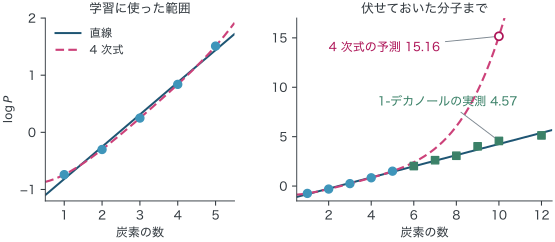
規則を複雑にしすぎて、学習に使ったデータには合うのに、新しいデータを外すことを、過学習と呼びます。過学習に気づくには、一部のデータを伏せておいて答え合わせをします。
もう1つ、「学んだ規則は、どんな分子にも使える」と考えるのは誤りです。ブドウ糖は炭素が6個なので、この規則で予測すると +2.00 になります。 ところが、ブドウ糖は O–H を5つもつので、実測はおよそ −3 です。OH を1つもつアルコールしか学んでいないので、外れたのです。
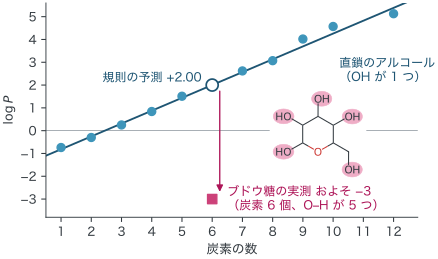
🖐 さわってみよう本の図 5-6・5-7・5-10・5-11
アルコールの log P から、直線を学ぶ
「学習する」を押すと、直線が少しずつデータに寄っていきます。学んだ直線で、まだ測っていない分子の log P を予測し、答え合わせもできます。
log P = × 炭素の数
- 測った分子(学習に使う)
- 点と規則のずれ
- まだ測っていない分子
- 答え(実測)
| 分子 | 予測 | 実測 | ずれ |
|---|
データ:直鎖アルコールの log P 実測値(J. Sangster, J. Phys. Chem. Ref. Data 18, 1111 (1989) の推奨値)。
はじめの直線は、学習のようすが見えるように、わざと外してあります。最後の「おまけ:覚えすぎると…」で、5つの点を全部通る4次式(図 5-11)を重ねられます。
化学で使われはじめた AI
人のように判断したり、文章を書いたりするコンピュータのしくみを、人工知能(AI)といいます。質問に答えて文章を書く AI も、たくさんの文章から、次に来る言葉を予測する規則を学んでいます。 AI の規則の形は、直線よりずっと複雑です。よく使われるのは、簡単な計算を何層にも重ねた、パラメータをとても多くもつ規則の形で、ニューラルネットワークと呼びます。 それでも、データを渡し、予測と正解の誤差を小さくするようにパラメータを直していく、という学習の考え方は、直線と同じです。
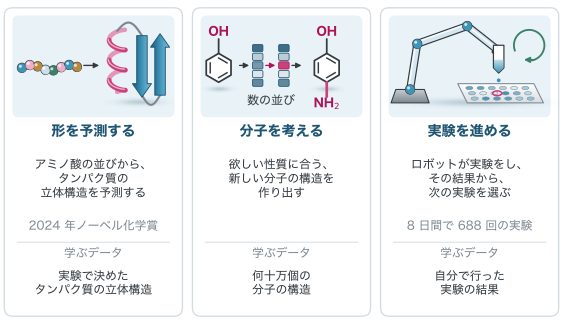
1つ目は、タンパク質の形を予測する AI です。立体構造を実験で1つ得るのに何年もかかることも多く、これまでに実験で決められた立体構造は約 20 万です。 2020年に発表された AlphaFold2 は、アミノ酸の並びだけから、鎖が折りたたまれた形を予測します。答えを伏せた予測の腕比べでは、多くのタンパク質で、実験で決めた構造に近い精度で予測しました。 その予測はおよそ 2 億にのぼります。2024年のノーベル化学賞の半分は、これを作ったハサビスとジャンパーに贈られました。
2つ目は、新しい分子を考える AI です。分子を数の並びに置きかえ、その数を少しずつ変えて、欲しい性質に近い新しい分子の構造を作り出します。 3つ目は、実験を進める AI です。2020年に報告された例では、ロボットが、光を当てると水から水素を作る材料で、はじめの6倍の活性をもつ組み合わせを見つけました。
新しい抗菌薬の候補探しにも使われています。2020年に報告された研究では、分子を実験で試して、大腸菌の増殖を止めるかどうかのデータを集め、分子の構造から増殖を止めるかどうかを予測する規則を学習させて、別の分子の集まりから候補を選びました。 その1つのハリシンは、これまでの抗菌薬とは構造が大きくちがう分子でした。第 3 章ではドッキングの点数で分子をふるいにかけましたが、この研究では、実験のデータから学んだ規則でふるいにかけたのです。それでも、最後に効き目を確かめたのは実験でした。
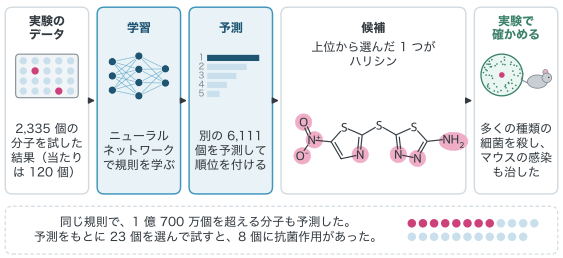
どの AI も、学んだデータの範囲の外では外れることがあり、最後は実験で確かめます。 実は、原子寄与法では CH₂ 1つぶんの寄与が +0.39 でしたが、この章で学んだ規則では +0.56 です。どちらを信じればよいのかは、第 6 章で、計算と実測を並べて確かめます。
山本研究室の化学工学チームは、分子動力学と量子化学計算に機械学習を組み合わせて、ゴムや多孔質材料の性質を予測し、合成する前に計算で当たりをつけることを目指しています。 量子化学の計算結果を学習して、分子動力学に正確な力を渡す使い方もあります。機械学習が研究の中でどう使われているかは、研究内容の「研究手法」の節で紹介しています。
MISSION CLEAR
ミッション・クリア! 答えはタミフルでした
- ① くぼみにはまる:リレンザと同じ骨組みを残し、①の枝はくぼみの中の油になじむすき間に入りこむので、はさみのくぼみにはまります。
- ② 体に届く:水になじむ部分を4か所書き換えて、log P を −3.79 から +1.29 に上げました。小腸の細胞膜を通り抜けられます。
- ※ 書き換え④のエステルは、飲んだあと体の中で外れ、くぼみにはまる形に戻ります(プロドラッグ)。
コンピュータがしたこと
- STEP 1 敵を知る:ねらう場所を、はさみ(ノイラミニダーゼ)のくぼみに決めた
- STEP 2 探す:くぼみにはまるかを点数にして、たくさんの候補を作る前にふるいにかけた
- STEP 3 予測する:作る前に log P を計算して、膜を通れる形に書き換えた
- STEP 4 学ぶ:その log P の計算の道具を、実際に測ったデータから作った